IA souveraine : trois arbitrages avant le modèle
L'IA générative quitte le stade du pilote. Elle lit les factures fournisseurs et alimente l'ERP, elle interroge des décennies d'archives juridiques, elle contrôle des effets de commerce et répond aux clients d'un service bancaire. À mesure qu'elle entre dans les processus critiques, la question change de nature : il ne s'agit plus de savoir quel modèle est le plus performant, mais quelles données il peut voir, sur quelle infrastructure, et à quel prix pour l'indépendance de l'entreprise.
Pourtant, la plupart des projets commencent encore par le choix du modèle. C'est prendre le problème à l'envers. Dans un projet d'IA d'entreprise, le modèle n'est pas une décision de départ : c'est la conséquence de trois arbitrages structurels qui le précèdent.
En bref
- Souveraineté : la donnée décide de l'hébergement, flux par flux, et l'architecture cible est hybride par conception.
- Capacité : sur une infrastructure maîtrisée, la ressource est finie ; le bon modèle est le plus petit qui atteint l'exigence métier.
- Réversibilité : les modèles changent tous les trimestres, les applications durent des années ; l'architecture doit absorber ce décalage.
Du pilote au processus critique
Un pilote tolère presque tout : une API cloud, un modèle surdimensionné, une intégration ad hoc. Un processus critique, non. Il engage la responsabilité de l'entreprise sur la confidentialité des données, il exige un coût prévisible et il doit fonctionner pendant des années, au-delà de la durée de vie de n'importe quel modèle.
Ces trois exigences correspondent à trois arbitrages. Chacun réduit l'espace des choix possibles. Pris dans l'ordre, ils laissent à la fin un petit nombre de modèles candidats ; pris à l'envers, ils obligent à reconstruire l'architecture dès la mise en production.
La souveraineté se décide par flux
Le premier arbitrage n'est pas technique : il est juridique et stratégique. Où chaque donnée a-t-elle le droit d'être traitée ? Une facture fournisseur, un dossier contentieux et une FAQ publique n'obéissent pas aux mêmes règles, et il serait aussi coûteux de tout rapatrier sur site que risqué de tout confier au cloud.
L'unité de décision est donc le flux de données, pas le projet. Chaque flux reçoit une règle d'hébergement selon sa sensibilité, les transferts autorisés et la localisation imposée : infrastructure interne, cloud souverain opéré, ou API publique. Il en résulte une architecture hybride, où chaque traitement est placé là où il a le droit d'être.
Cet arbitrage relève de la direction, du juridique et de la conformité avant la DSI. S'il est laissé aux équipes techniques, il est tranché par défaut, souvent au profit de l'outil le plus simple à intégrer.
La capacité fixe le modèle
Dès qu'un flux doit rester sur une infrastructure maîtrisée, la logique s'inverse. Dans le cloud, la puissance de calcul paraît illimitée et se paie à l'usage. Sur site, elle est finie, achetée d'avance et partagée entre plusieurs services. La contrainte déterminante est la mémoire des cartes graphiques : un modèle qui n'y tient pas entièrement ralentit d'un ordre de grandeur.
Le raisonnement n'est donc plus « quel est le meilleur modèle ? », mais « quel est le plus petit modèle qui atteint l'exigence métier dans le budget de ressources disponible ? ». Les classements publics n'y répondent pas : ils mesurent des tâches génériques. Seul un banc d'essai sur la tâche réelle, avec les données réelles, permet de trancher. Ce n'est pas une étape de recette, c'est l'outil de décision qui arbitre entre exactitude, délai et coût d'infrastructure.
Bien conduit, cet arbitrage évite la dépense la plus fréquente des projets d'IA sur site : du matériel dimensionné pour un modèle qu'on n'avait pas besoin de faire tourner.
La réversibilité protège l'investissement
Le modèle retenu aujourd'hui ne sera pas celui de l'an prochain. Les modèles se succèdent à un rythme trimestriel, les moteurs d'inférence aussi, alors que les applications métier s'amortissent sur plusieurs années. Lier les unes aux autres revient à programmer leur obsolescence.
La réponse est architecturale : une passerelle unique entre les applications et les modèles, avec des noms de modèles traités comme de la configuration. Changer de modèle, de moteur ou basculer un flux vers le cloud devient alors un réglage, pas un projet. C'est aussi la meilleure protection contre la dépendance, vis-à-vis d'un fournisseur de modèles comme d'un intégrateur.
La réversibilité suppose enfin d'exploiter un modèle local comme n'importe quel service de production : supervision, gestion de la capacité, mises à jour maîtrisées. Les dégradations d'un LLM sont rarement des pannes franches ; ce sont des lenteurs silencieuses, que seule une supervision adaptée révèle.
Illustration : un déploiement réel
Ces trois arbitrages se vérifient sur nos propres déploiements, menés volontairement sur un matériel modeste : deux cartes graphiques grand public de 16 Go, partagées entre plusieurs services.
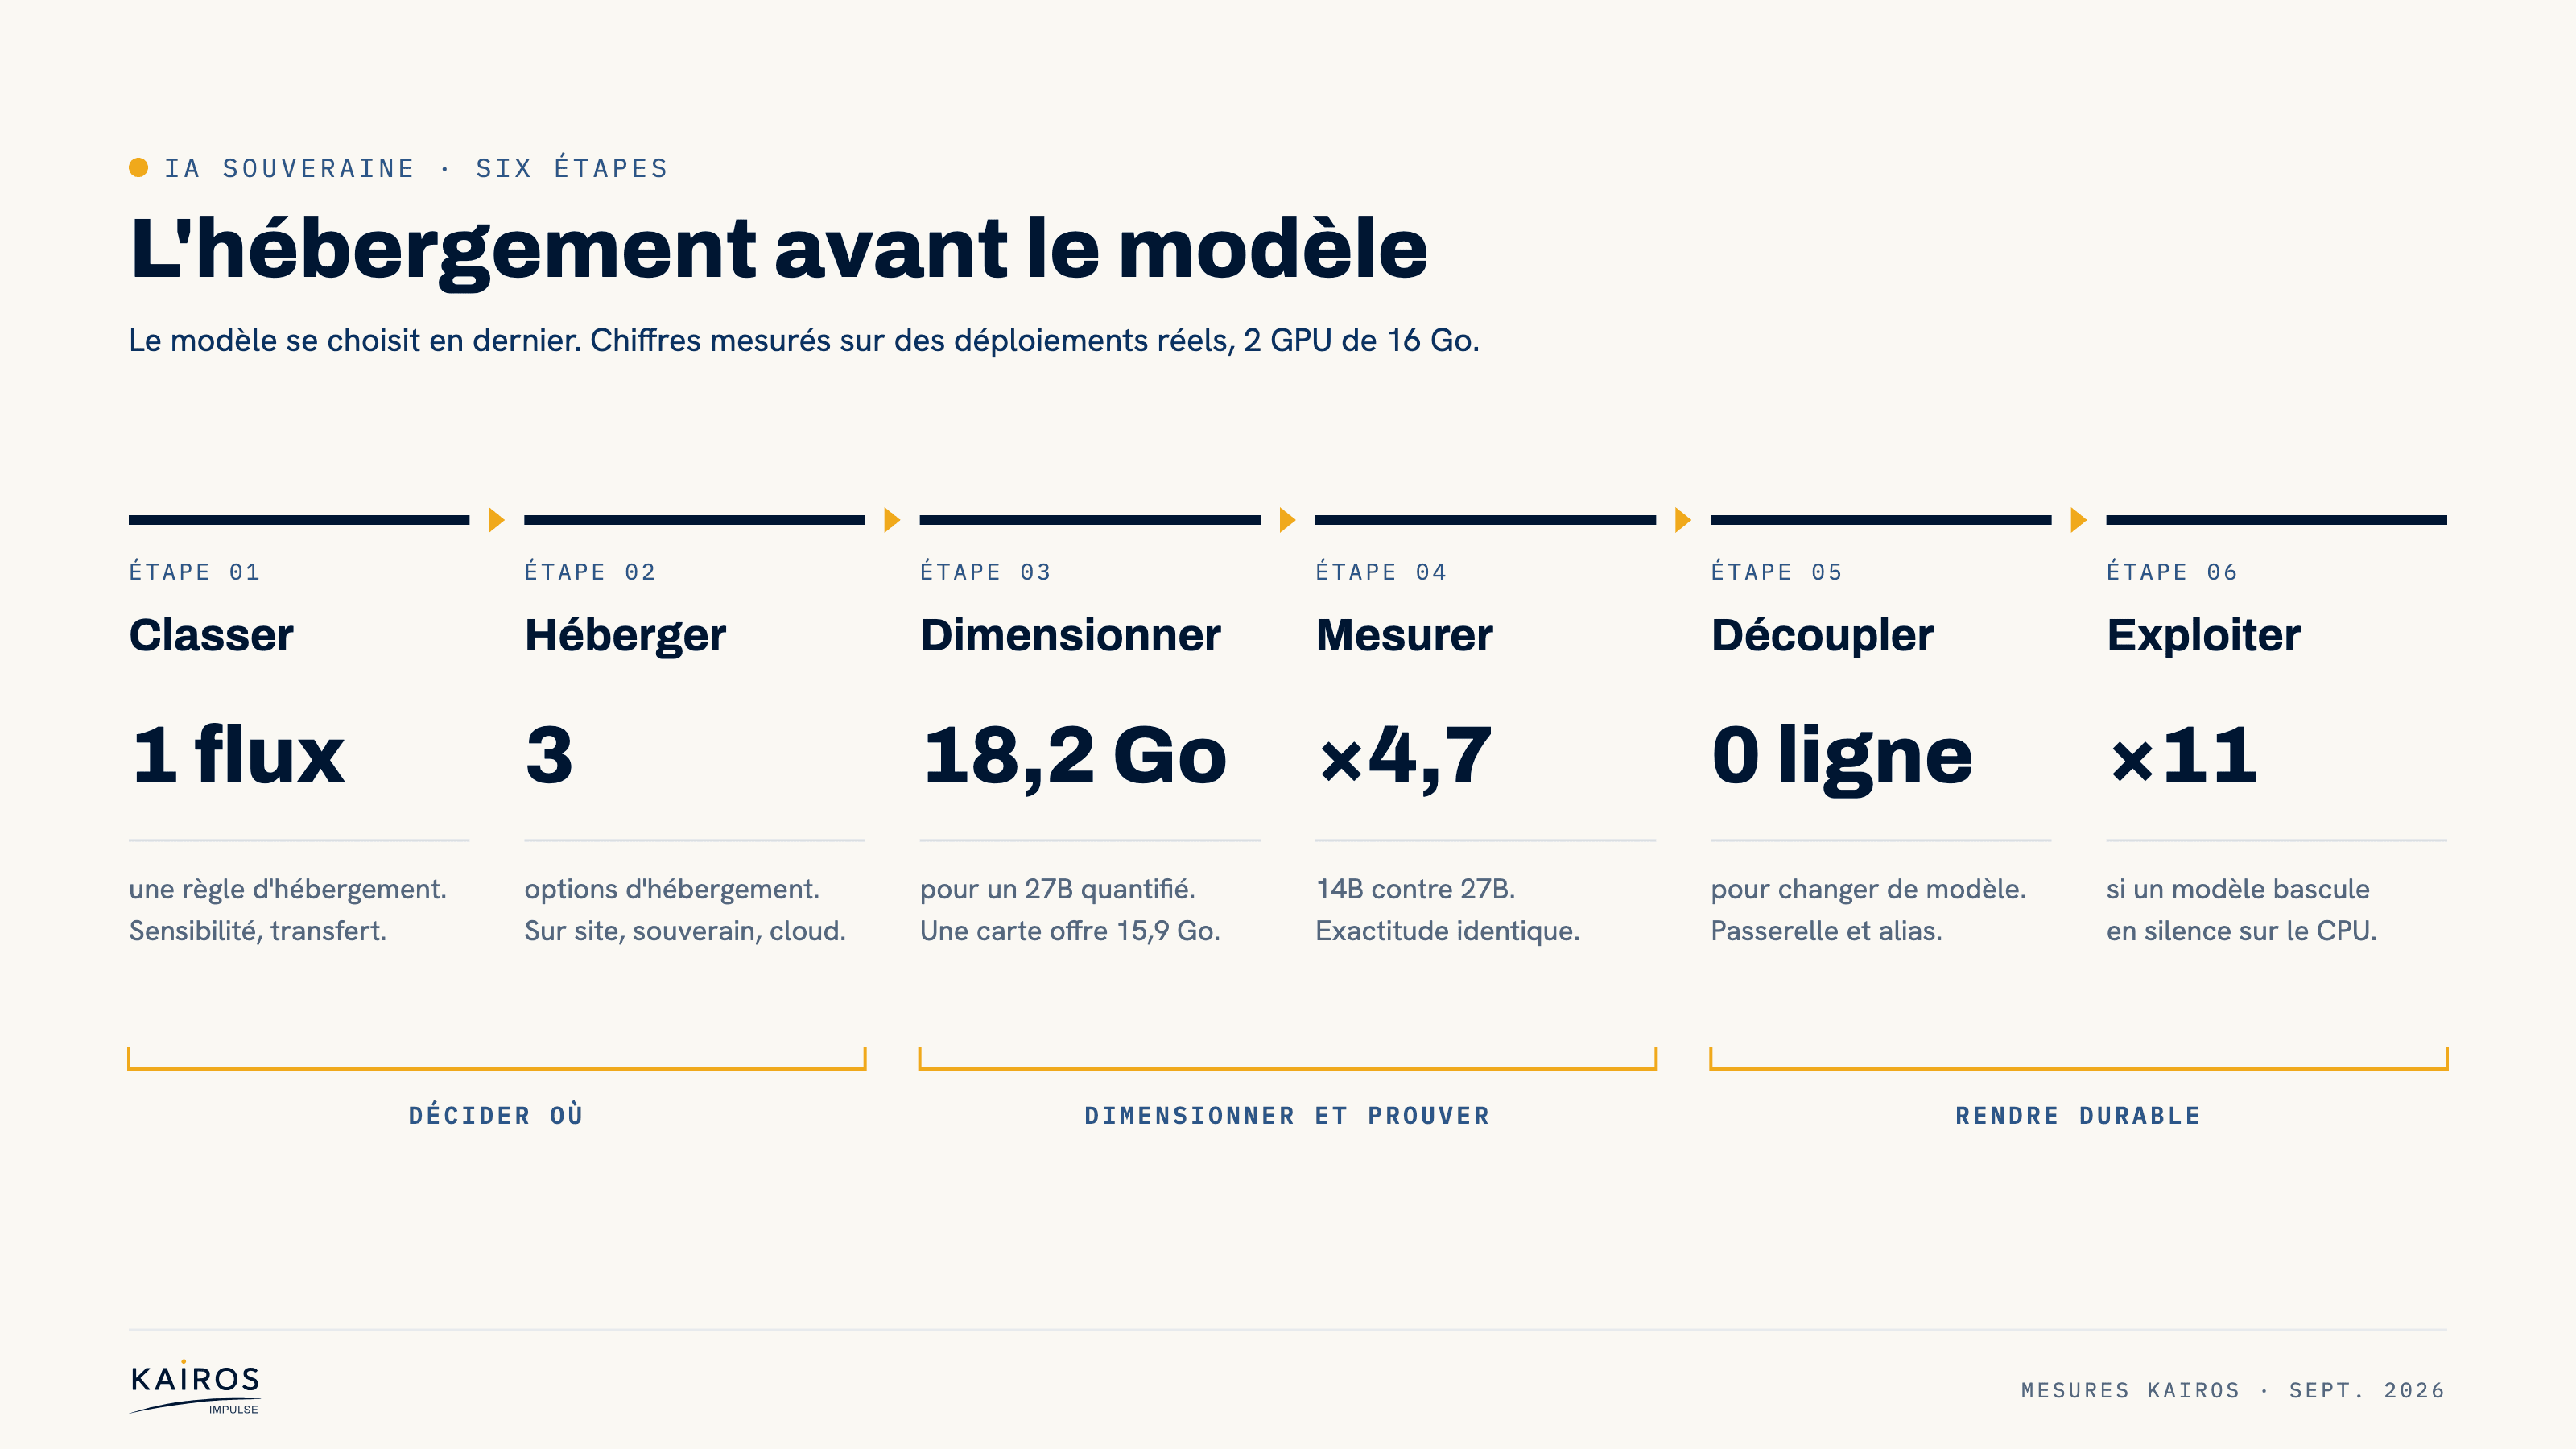
Souveraineté. Les flux documentaires sensibles ont été classés en traitement local ; les autres pouvaient rester dans le cloud. Le périmètre sur site s'est ainsi limité à ce qui devait réellement y être.
Capacité. Quantifié sur 4 à 5 bits, Qwen3.6-27B occupe 18,2 Go avec un contexte de 2 048 tokens : il ne tient pas sur une carte, et l'étaler sur les deux priverait les autres services de leur mémoire. Le banc d'essai a confirmé l'intérêt de ne pas viser plus gros. Sur une même extraction de données en JSON, Qwen3-14B rend un résultat exact en 33 secondes, Qwen3.6-27B le même résultat en 156 secondes, et Gemma 4 12B n'aboutit pas sur cette tâche.
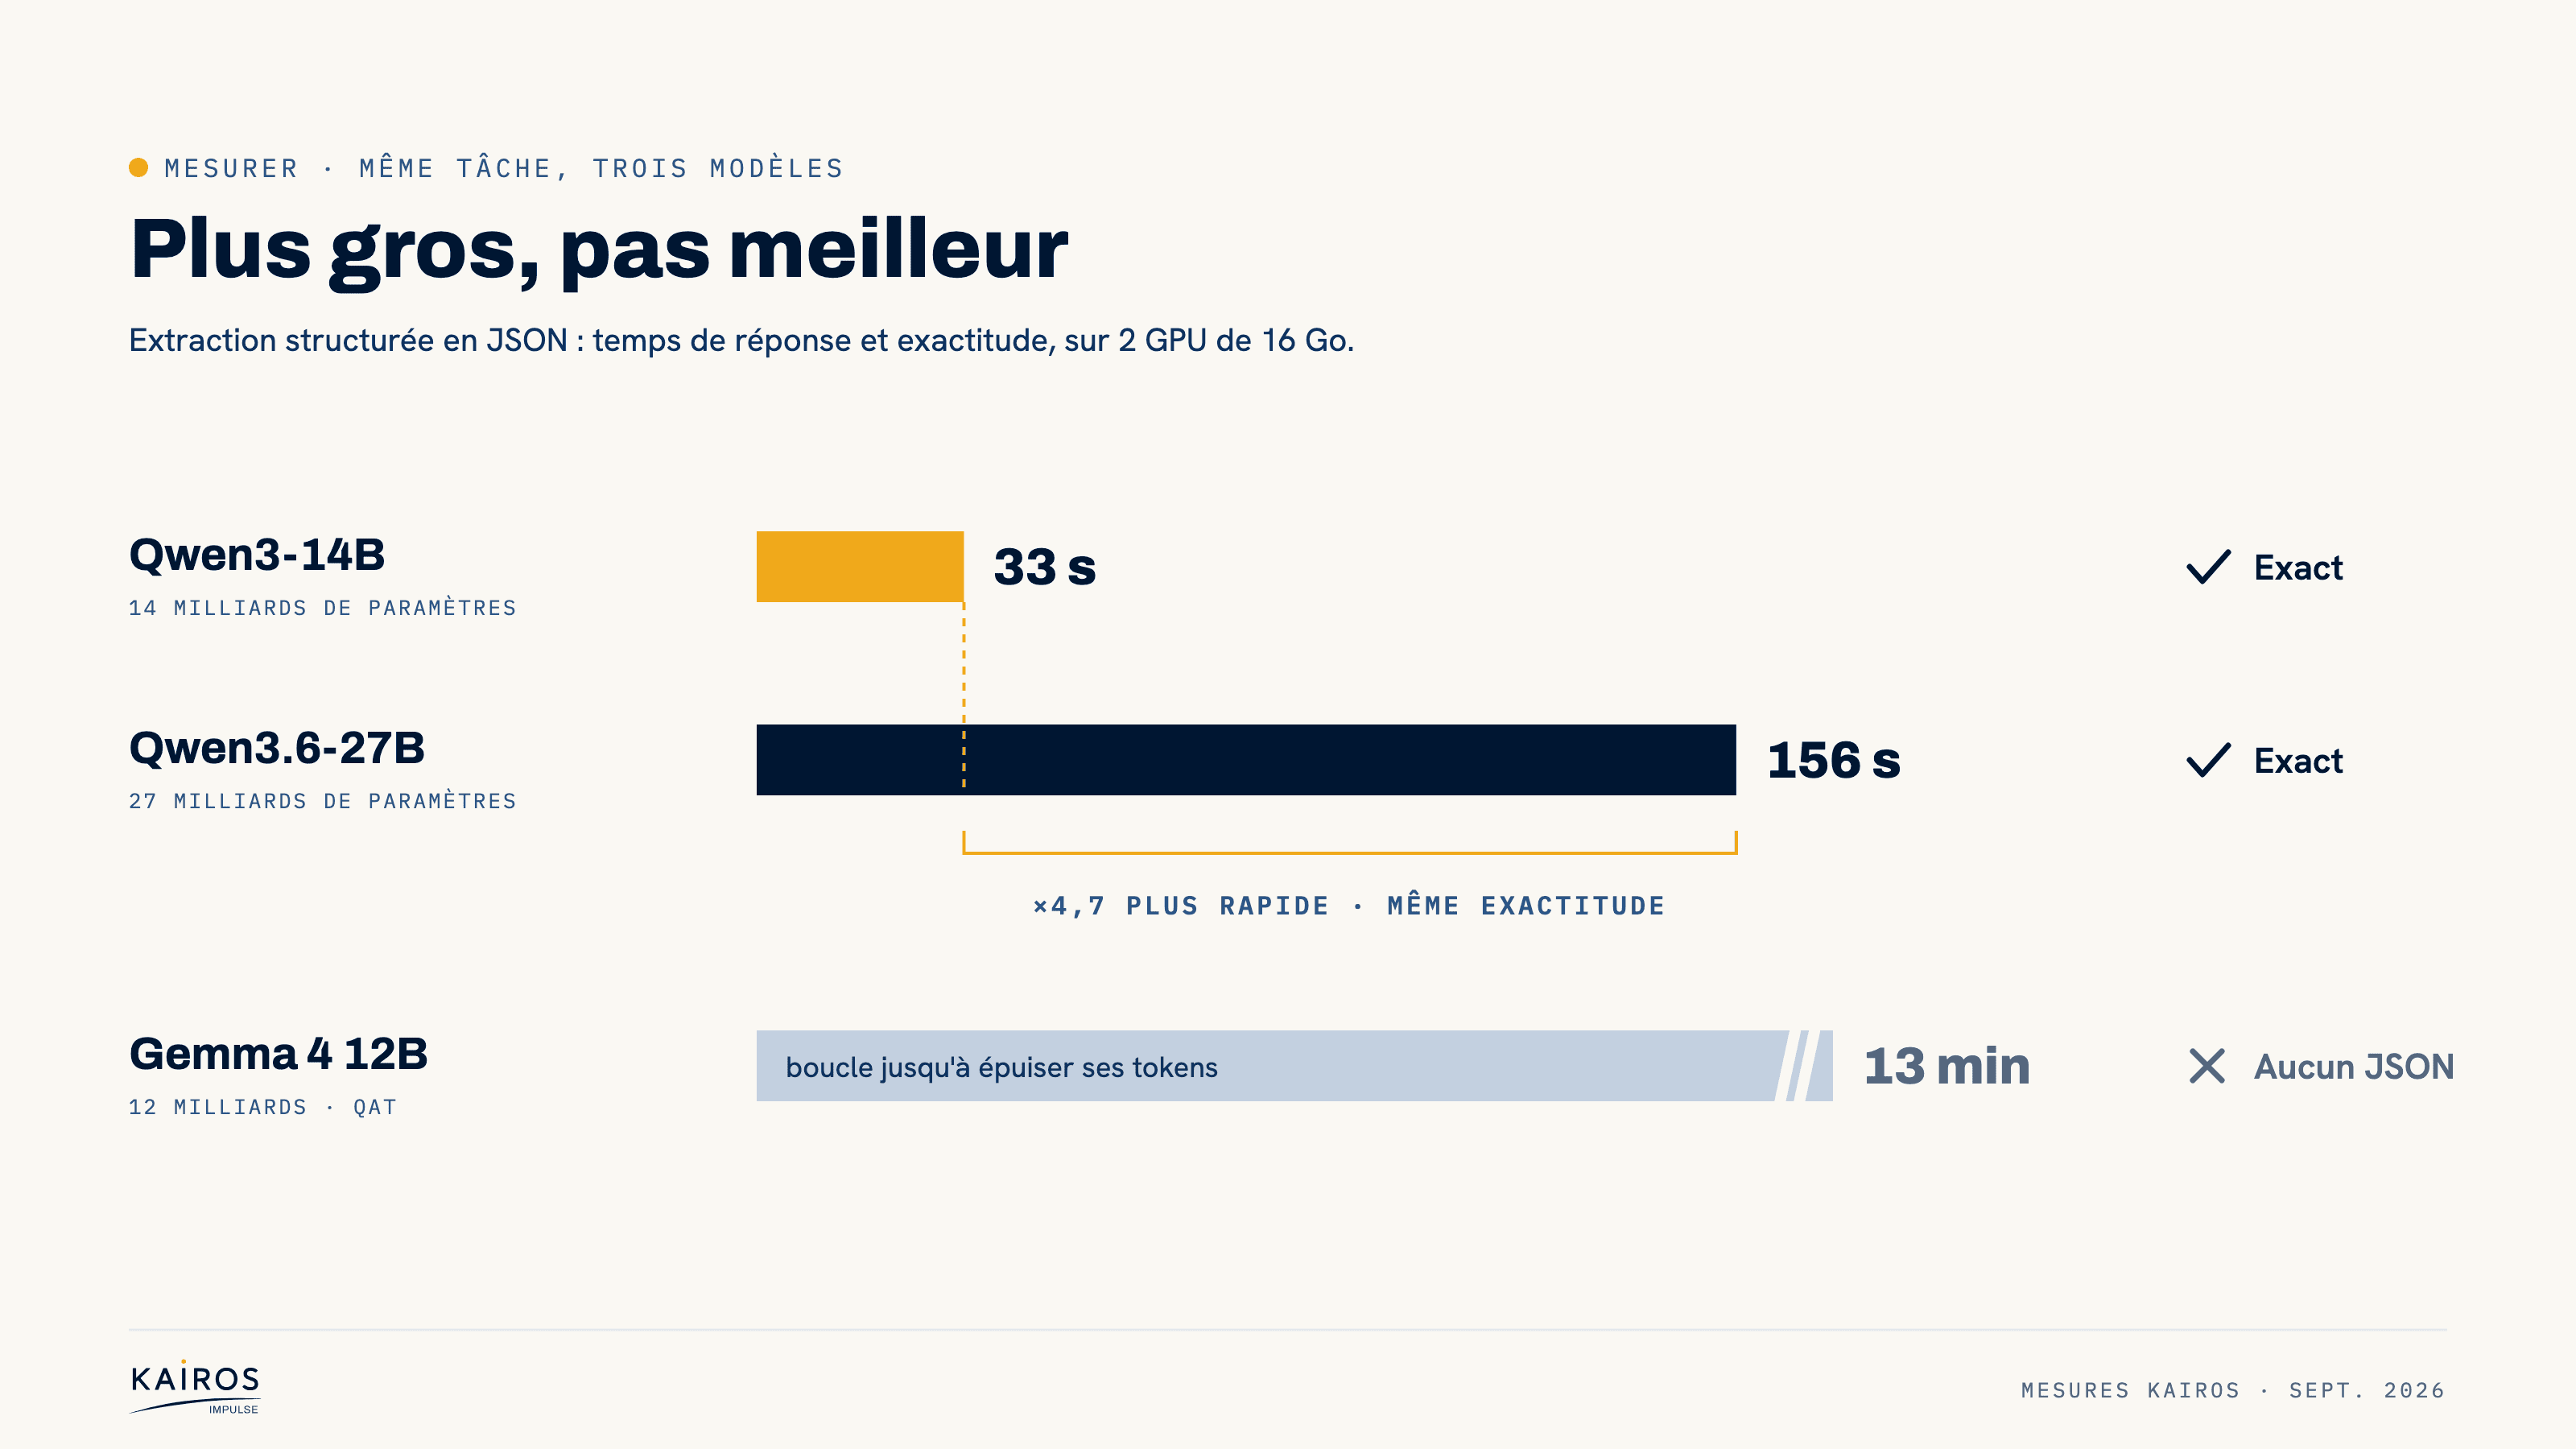
Le plus gros modèle n'était pas plus exact : il générait trois fois plus de tokens de raisonnement pour arriver au même résultat. Le 14B offre la même exactitude près de cinq fois plus vite, sur une seule carte.
Réversibilité. Toutes les applications passent par une passerelle compatible avec l'API d'OpenAI, de type LiteLLM, avec des alias de modèles. C'est l'exploitation qui a révélé l'enjeu de supervision : faute de mémoire libre, un modèle s'exécutait aux trois quarts sur le processeur, sans erreur ni alerte. Une fois chaque service affecté à sa propre carte, le pipeline est devenu onze fois plus rapide. Nous surveillons depuis la part de chaque modèle réellement chargée en mémoire graphique, et pas seulement sa disponibilité.
Ce que les décideurs doivent trancher
Avant de lancer un projet d'IA sur des données sensibles, trois questions méritent une réponse explicite au niveau de la direction :
- Quels flux n'ont pas le droit de quitter notre infrastructure, et qui en a décidé ?
- Quel niveau d'exigence métier visons-nous, et l'avons-nous mesuré sur notre tâche avant de dimensionner le matériel ?
- Que coûterait un changement de modèle le trimestre prochain : un réglage ou un projet ?
Notre approche
Chez KAIROS Impulse, nous conduisons ces trois arbitrages dans cet ordre, sur les données réelles du client. Le modèle arrive en dernier, et l'architecture permet au client d'en changer sans dépendre de nous. Notre principe : transférer une capacité, pas créer une dépendance.
Le bon modèle est celui que votre infrastructure peut faire tourner sans incident pendant des années.
Commentaires
Soyez le premier à commenter cet article.
Le Brief KAIROS
Recevez notre lecture mensuelle de l'IA.